Qu'est-ce qu'un token en intelligence artificielle ?
 Rédigé parLucas OllivierConsultant SEO, fondateur de Digitalink
Publié le
Un token est l'unité de texte que lit et produit un modèle de langage comme ChatGPT ou Gemini. C'est un morceau de mot, un mot entier ou un signe de ponctuation. Les IA comptent en tokens leur capacité de lecture, la longueur de leurs réponses et leur coût.
Un mot, plusieurs tokens
Avant de lire un texte, le modèle le découpe en tokens grâce à un outil appelé tokeniseur. Les mots courants forment souvent un seul token ; les mots longs ou rares sont coupés en plusieurs morceaux. Par exemple, « maison » peut tenir en un token, alors qu’« anticonstitutionnellement » sera découpé en plusieurs.
Les espaces, la ponctuation, les chiffres et les émojis comptent aussi comme des tokens ou des morceaux de tokens.
Combien de tokens pour un texte
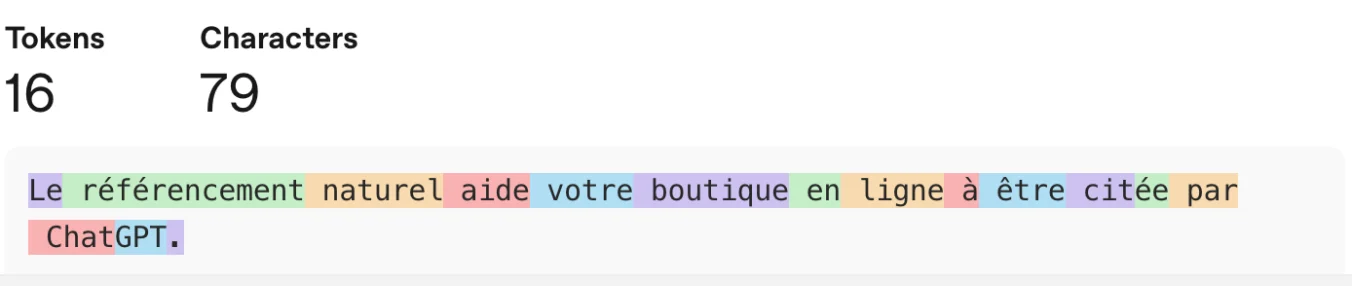
OpenAI donne une règle approximative pour l’anglais : un token correspond à environ 4 caractères, et 100 tokens représentent à peu près 75 mots. En français, il faut compter un peu plus de tokens pour le même texte : les mots sont plus longs, les accents et les formes conjuguées multiplient les découpages. Dans l’exemple ci-dessus, 12 mots donnent 16 tokens.
Chaque famille de modèles a son propre tokeniseur : une même phrase ne donne pas exactement le même nombre de tokens chez OpenAI, Google, Anthropic ou Mistral.
Pourquoi les tokens comptent
| Ce qui se mesure en tokens | Ce que ça change |
|---|---|
| La fenêtre de contexte | La quantité de texte que l'IA peut lire d'un coup, documents et conversation compris |
| La longueur des réponses | Une limite fixe le nombre maximum de tokens produits |
| Le coût | Les API sont facturées par million de tokens lus et générés |
| La vitesse | Plus il y a de tokens à produire, plus la réponse est longue à arriver |
Un exemple concret
Une IA qui répond avec la recherche web, selon le principe du RAG, ne lit pas vos pages en entier : elle en extrait des passages, dans la limite de ce qu’elle peut traiter. Une page qui donne l’information clé dès les premières lignes, en paragraphes courts, a plus de chances que ce passage soit retenu qu’une page où la réponse arrive après mille mots d’introduction.
Pourquoi c’est important pour votre business
- Pour vos contenus : l’attention des IA est limitée. Les informations importantes doivent être faciles à trouver et à extraire, en tête de page et de section.
- Pour vos projets IA : si vous utilisez une IA dans votre entreprise, le nombre de tokens détermine le coût d’un chatbot, d’une génération de fiches produits ou d’une analyse de documents.
- Pour comprendre les limites : quand une conversation devient trop longue, le LLM « oublie » le début, ce qui peut favoriser les hallucinations.
Fenêtre de contexte : ce que l’IA peut lire d’un coup
La fenêtre de contexte est la mémoire de travail du modèle, comptée en tokens. Elle contient tout ce qu’il prend en compte pour répondre : vos instructions, l’historique de la conversation et les documents ou pages ajoutés, par exemple lors d’une recherche web. Les modèles récents acceptent des fenêtres très grandes, l’équivalent de plusieurs livres, mais deux limites restent :
- Tout ce qui dépasse la fenêtre est ignoré.
- Même dans la fenêtre, un modèle exploite moins bien les informations noyées au milieu d’un très long texte.
Les erreurs fréquentes
- Confondre token et mot. Un texte de 1 000 mots fait plus de 1 000 tokens, surtout en français.
- Croire qu’une IA lit tout. Au-delà de sa fenêtre de contexte, elle ne prend plus en compte le début.
- Remplir les pages de texte inutile en pensant aider les IA : elles retiennent les passages clairs, pas les plus longs.
Questions fréquentes
Combien de tokens fait un mot ?
Cela dépend de la langue et du mot. OpenAI indique qu'en anglais, un token correspond en moyenne à environ 4 caractères, soit à peu près trois quarts de mot. En français, un même texte demande en général un peu plus de tokens, car les mots sont plus longs et plus variés.
Qu'est-ce que la fenêtre de contexte ?
C'est le nombre maximum de tokens qu'un modèle peut prendre en compte en même temps : la question, l'historique de la conversation et les documents fournis. Au-delà, il ne « voit » plus le début du texte.
Pourquoi les IA sont-elles facturées au token ?
Parce que le coût de calcul dépend directement du nombre de tokens lus et produits. Les API des modèles affichent ainsi des prix par million de tokens, souvent différents pour le texte envoyé et le texte généré.